

Расширение
Сервисы
ИИ-инференса
Запускайте ИИ‑модели как готовые сервисы: Deckhouse автоматически подбирает конфигурацию, масштабируется под нагрузку и контролирует работу каждого из них.
Расширение находится на стадии Tech Preview. Оставьте заявку, чтобы получить доступ первыми.
Для работы требуется расширение «Управление GPU»


Ускорение запуска
Платформа сама проверяет модель, развёртывает сервис и выдаёт адрес с ключом доступа. Интеграция ИИ в приложение происходит по одному заказу.

Производительность под задачу
Выбирайте приоритет — минимальную задержку, максимальный поток запросов или баланс. Deckhouse подберёт GPU-профиль и параметры запуска.

Эффективное использование GPU
«Сервисы ИИ-инференса» рассчитывают конфигурацию, а модуль управления GPU выделяет запрошенные устройства через DRA.

Контроль работы
Число реплик меняется автоматически в заданных границах. В статусе и метриках видны готовность сервиса, реплики и причины возможных проблем.

Безопасность данных
Обработка запросов выполняется в инфраструктуре компании. Внутренняя или внешняя публикация, токен и TLS задаются политикой доступа.
Как Deckhouse запускает ИИ-модели
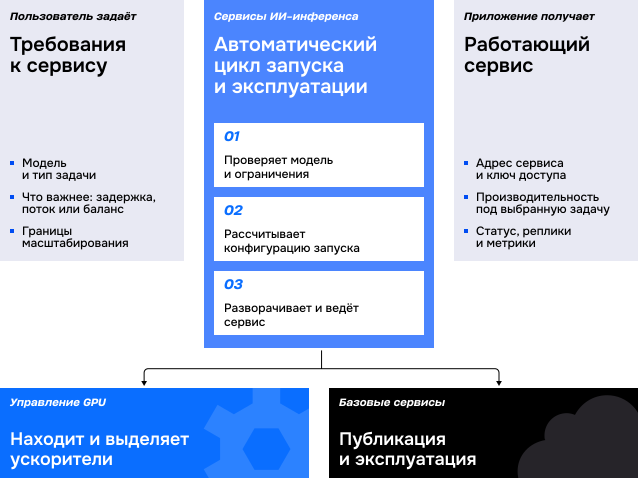
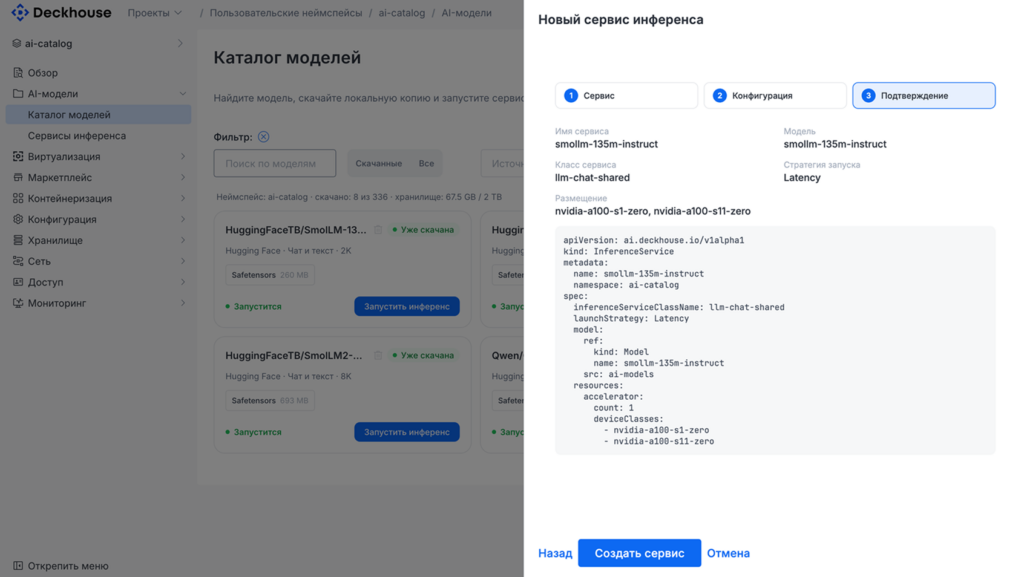
Пользователь создаёт InferenceService: выбирает модель из внутреннего каталога или указывает репозиторий Hugging Face напрямую, задаёт класс сервиса, режим работы и границы масштабирования. Перед запуском платформа проверяет доступность модели и правила класса, сопоставляет требования модели с актуальным инвентарём GPU.
По рассчитанному плану платформа запрашивает GPU через DRA, доставляет модель, создаёт рабочую нагрузку, настраивает механизм масштабирования и предоставляет API с ключом доступа.
Сервис переходит в статус Ready только после проверки рабочей нагрузки и ответа модели.
Работа с расширением
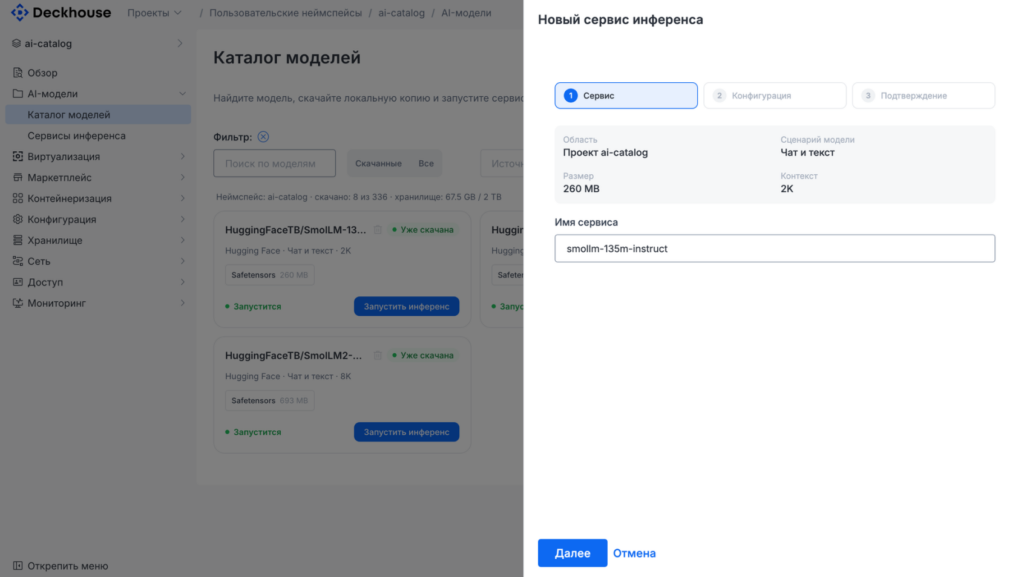
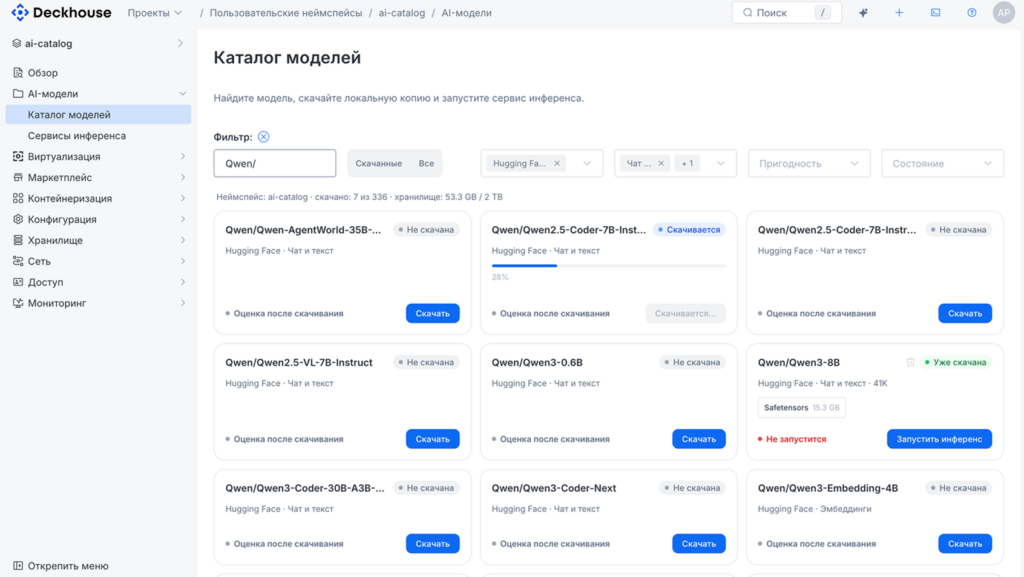
Используйте модель из внутреннего каталога или укажите репозиторий Hugging Face напрямую. Каталог можно пополнить из файлов, импортировать из Ollama или других кластеров.
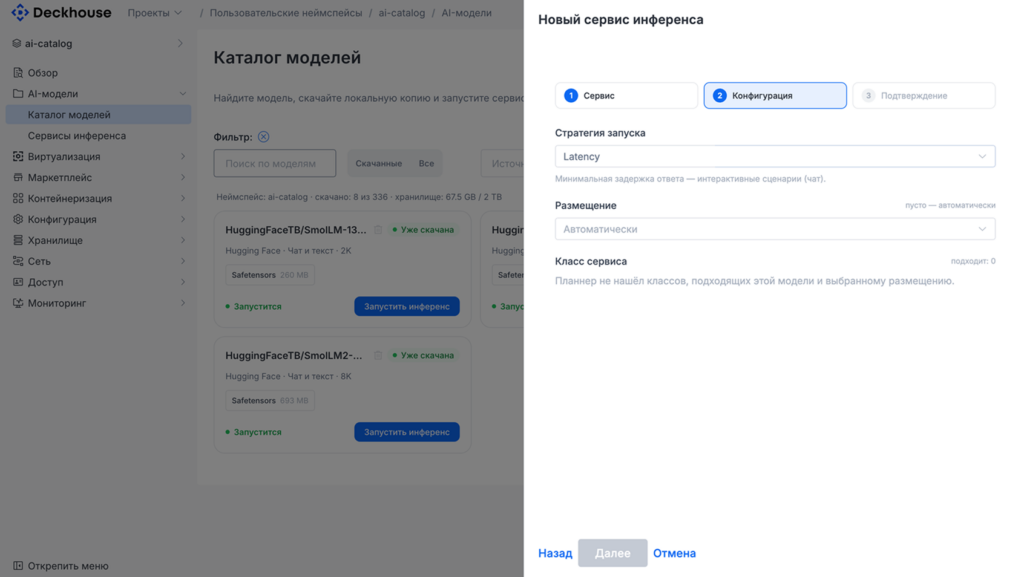
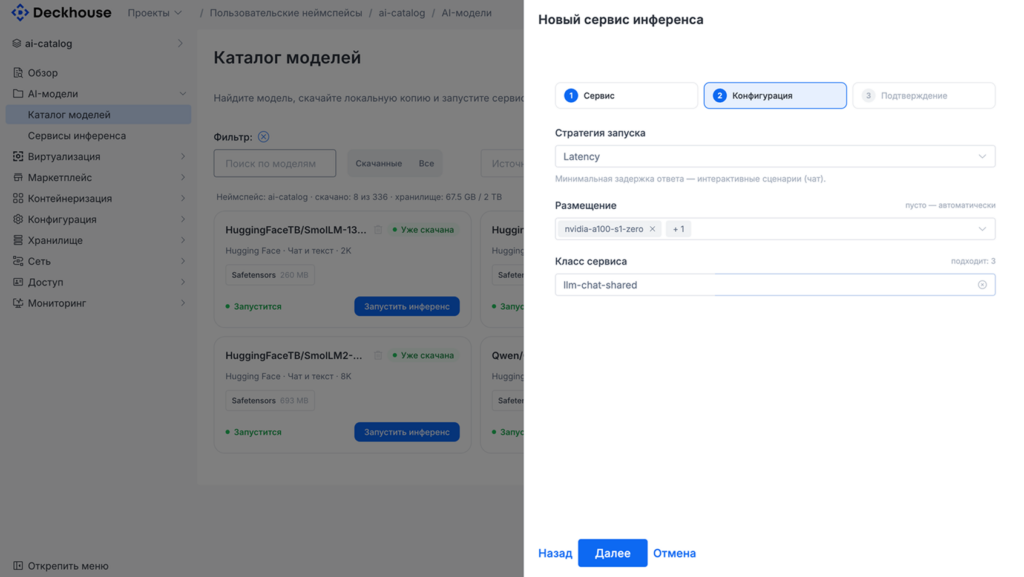
Вы задаете приоритет — скорость отклика (минимальная задержка), пропускная способность или баланс. Здесь же определяются границы автоматического масштабирования: минимальное и максимальное число реплик.
Платформа автоматически рассчитывает GPU‑профиль, объём памяти и параметры рантайма.
Когда сервис готов к эксплуатации, он становится доступен по API. Если политика безопасности требует авторизации, генерируется ключ доступа.
Вы видите состояние каждого сервиса в реальном времени: готовность, число реплик и метрики. При возникновении проблем с моделью или GPU причина сбоя сразу отображается в статусе.
Рекомендуем в составе готовых решений
Проконсультируем по запуску ИИ-сервисов в вашей инфраструктуре
Поможем подобрать архитектуру под ваши задачи и покажем возможности Deckhouse для управления GPU и инференсом моделей.
Часто задаваемые вопросы
В каких редакциях платформы доступны «Сервисы ИИ-инференса»?
Расширение входит в состав редакции Deckhouse Platform Ultimate, а также доступно как дополнение к Deckhouse Platform Core.
Как развернуть LLM в собственном Kubernetes-кластере?
Создайте сервис, выберите модель и режим работы. Deckhouse Platform проверит совместимость, подберёт ресурсы, запустит модель и предоставит адрес для подключения приложения.
Нужно ли вручную подбирать GPU и параметры запуска?
Нет. Вы задаёте приоритет — минимальную задержку, максимальную пропускную способность или баланс, — а платформа подбирает конфигурацию из доступных ускорителей. Если ресурсов недостаточно, причина видна до запуска.
Как сервис масштабируется под нагрузкой?
Вы задаёте минимальное и максимальное число реплик. Платформа автоматически меняет их количество под нагрузкой и показывает причины, если новая реплика не запускается.
Остаются ли данные внутри инфраструктуры компании?
Да. Запросы к модели обрабатываются в собственном контуре, а сервис можно оставить доступным только внутри компании. Если нужен внешний доступ, он защищается токеном и TLS.
Как лицензируется расширение «Сервисы ИИ-инференса»?
Расширение лицензируется в единицах мощности подключённых графических ускорителей — GCU. Количество GCU для каждого графического ускорителя определяет каталог. Если в каталоге нет нужного графического ускорителя, напишите нам на contact@deckhouse.ru, и мы посчитаем количество.