Нагрузка на узлы меняется со временем, а узлы иногда выходят из строя. Deckhouse Platform (DP) выравнивает размещение виртуальных машин (ВМ) по узлам и перезапускает машины отказавшего узла, а метрики помогают понять, почему машина работает медленно.
Перебалансировка ВМ
Со временем распределение виртуальных машин по узлам перестаёт быть равномерным. Вернуть баланс умеет модуль descheduler, который переносит ВМ живой миграцией, не прерывая их работу. Включите этот модуль, и распределение будет поддерживаться без вашего участия.
Перебалансировка решает две задачи:
- выравнивает нагрузку. DP следит за тем, сколько процессорных ресурсов зарезервировано на каждом узле, и, когда узел резервирует больше 80%, переносит часть ВМ на узлы, где зарезервировано меньше 50%;
- восстанавливает корректное размещение. DP проверяет, отвечает ли текущий узел требованиям ВМ и правилам взаимного расположения ВМ. Например, если правила запрещают держать определённые ВМ на одном узле, лишние будут перенесены.
Настройки перебалансировки DP задаёт сам: при включённом модуле descheduler он создаёт ресурс Descheduler с именем virtualization и отбирает в нём только те машины, которые можно перенести живой миграцией. Как устроены стратегии вытеснения, описано в разделе «Вытеснение подов».
- В командной строке
- В веб-интерфейсе
Посмотреть настройки перебалансировки можно командой:
d8 k get descheduler virtualization -o yaml
- Перейдите на вкладку «Система», далее в раздел «Конфигурация» → «Deschedulers».
- Нажмите кнопку «Создать».
- В открывшемся окне «Создать ресурс» в поле «Имя» введите имя ресурса.
- На вкладке «Конфигурация» в блоке «Стратегии» включите нужные. Стратегия «Низкая загрузка узлов (балансировка)» переносит ВМ с перегруженных узлов, а «Нарушения Inter-Pod Anti-Affinity» и «Нарушения Node Affinity» восстанавливают корректное размещение.
- Нажмите кнопку «Применить».
Созданные ресурсы и включённые в них стратегии отображаются в списке раздела.
Перебалансировка касается только тех ВМ, которые могут уехать с узла живой миграцией. ВМ, которую мигрировать нельзя, например с проброшенным устройством, перебалансировка не трогает, потому что увезти её с узла можно только перезапуском. Такая ВМ перезапускается лишь при обслуживании узла и только с разрешения администратора.
Диагностика медленной работы ВМ
Замедление виртуальной машины вызывают две разные причины. Гостевая ОС либо занята собственными вычислениями, либо ожидает, когда узел выделит ей процессорное время. Снаружи оба случая выглядят одинаково, как загруженный процессор машины.
Различить их помогают метрики DP, поэтому заходить в гостевую систему не требуется. Дашборд Grafana «Virtualization VM Happiness» показывает, сколько каждая машина ждёт процессор и чего ей не хватает, а также какие узлы загружены сильнее остальных.
Дальнейшие действия зависят от того, какая из причин подтвердилась.
- Машина потребляет всю гарантированную долю процессора. Перенос на другой узел не поможет, потому что там гарантирована та же доля. Увеличьте долю ядра
.spec.cpu.coreFractionили уменьшите число виртуальных ядер, чтобы гостевая ОС не распределяла нагрузку по ядрам, которым процессорное время не достаётся. Со значениемAutoдолю подбирает DP по фактическому потреблению, поэтому вручную её не изменить, и остаётся изменить число ядер или задать явный процент. - Машина ожидает процессорное время, не выбрав гарантированную долю. Узел не обеспечивает заявленную гарантию, и перенос машины на менее загруженный узел устраняет задержки.
Гарантия не абсолютна при переподписке процессора. Процессорное время распределяется между машинами пропорционально их долям, поэтому машина с несколькими нагруженными ядрами среди множества конкурирующих может получить меньше гарантированного.
Освобождая узел, переносите машину с наибольшим потреблением, а не ту, работа которой замедлилась. Перенос основного потребителя высвобождает ресурсы узла, а перенос остальных машин даёт незначительный эффект.
Перед переносом проверьте возможность миграции, чтобы освобождение узла не обернулось перезапуском машины. Машину, которую удерживает хранилище, DP во многих случаях переносит вместе с её дисками, а машину с проброшенным устройством живой миграцией перенести нельзя.
Убедитесь также, что в кластере есть подходящий узел. Класс VirtualMachineClass ограничивает выбор узлами, процессоры которых соответствуют классу. Если в этом списке остаётся только текущий узел, миграция невозможна при любой нехватке ресурсов, и остаётся освободить сам узел, перенеся с него другие машины, либо назначить машине класс с более широким выбором узлов.
Задержки хранилища и сети DP измеряет сравнением с остальным кластером, а не с фиксированным порогом, потому что одна и та же задержка диска нормальна для реплицируемого тома и указывает на проблему для локального. Если хранилище одинаково медленное во всём кластере, перенос машины задержки не устранит.
ColdStandby
Механизм ColdStandby возвращает виртуальную машину в работу после отказа узла, на котором она была запущена.
Чтобы механизм работал, выполните два требования:
- политика запуска виртуальной машины
.spec.runPolicyдолжна иметь значениеAlwaysOnUnlessStoppedManuallyилиAlwaysOn; - на узлах, где запущены виртуальные машины, должен быть включён механизм Fencing.
Без Fencing механизм не работает. Недоступная ВМ в этом случае не переезжает, а остаётся на отказавшем узле и возобновляет работу вместе с ним.
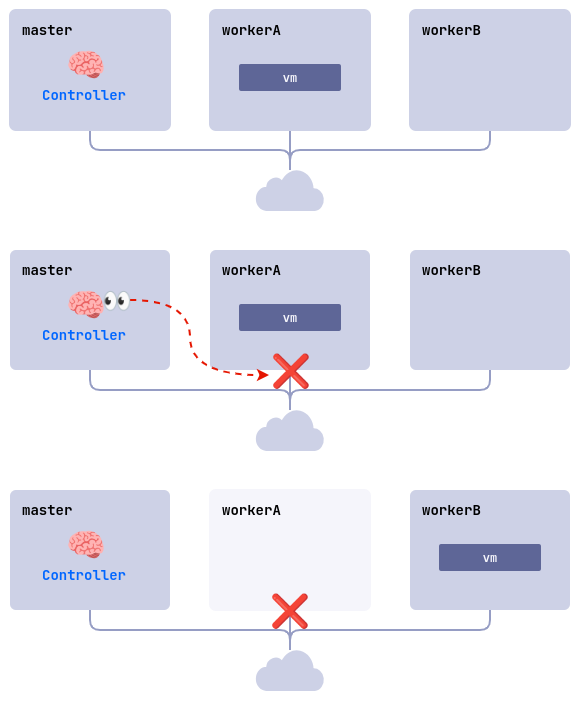
Порядок восстановления на примере кластера из трёх узлов master, workerA и workerB, где Fencing включён на обоих worker-узлах, а ВМ linux-vm запущена на workerA:
- Узел
workerAотказывает, например из-за потери питания или сети. - Контроллер проверяет доступность узлов и обнаруживает, что
workerAне отвечает. - Контроллер удаляет
workerAиз кластера. - ВМ
linux-vmзапускается на другом подходящем узле, в примере этоworkerB.