Процессорные ресурсы машины задаются числом ядер и долей ядра, а допустимые сочетания ограничивает класс виртуальной машины (ВМ).
Настройки CPU и coreFraction
Процессорные ресурсы машины задают два параметра. Параметр .spec.cpu.cores определяет число виртуальных ядер, а .spec.cpu.coreFraction — гарантированную долю мощности каждого из них.
spec:
  cpu:
    cores: 2
    coreFraction: 20%
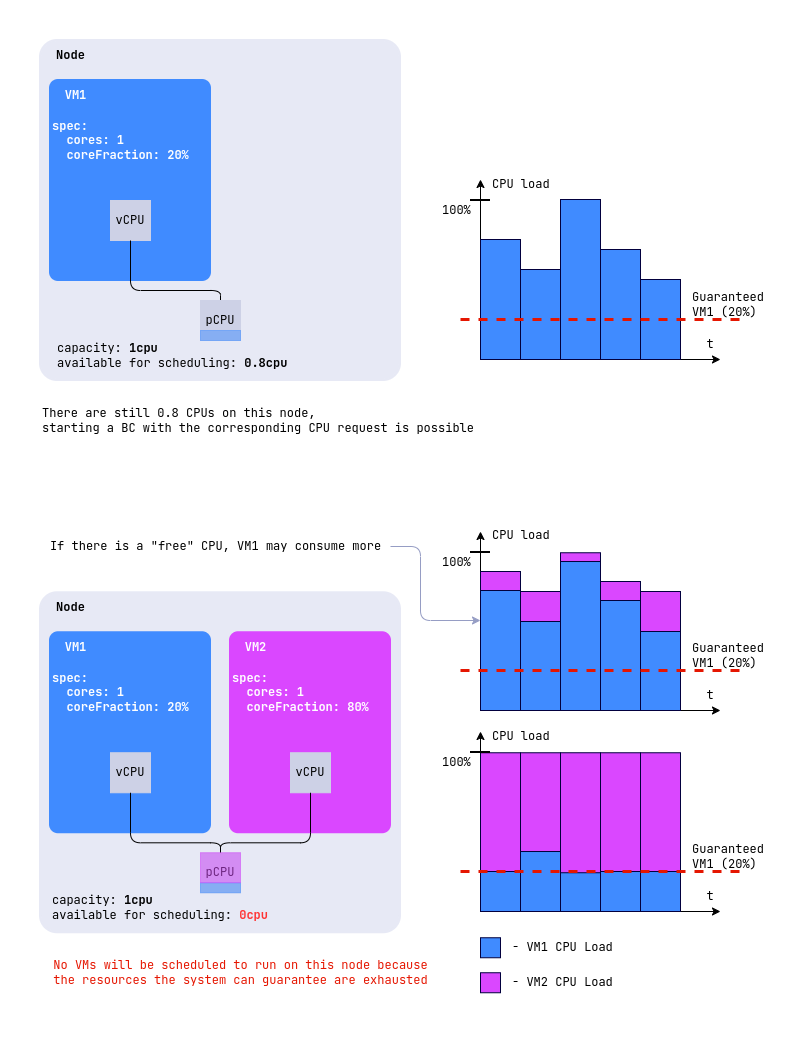
В этом примере машина получает два виртуальных ядра и гарантированные 20% мощности каждого, то есть 0,4 ядра в сумме, независимо от загрузки узла. Когда на узле есть свободные ресурсы, машина может занять оба ядра целиком. Такой запас позволяет держать на узле больше машин, чем на нём физических ядер, и при этом не терять стабильность под нагрузкой.
Если coreFraction не задан, каждое виртуальное ядро получает 100% физического.
Администратор может ограничить набор допустимых значений coreFraction в политике сайзинга класса ВМ, и тогда выбирать придётся из них.
Гарантированная доля учитывается при выборе узла, поэтому машина не запустится там, где узел не может обеспечить гарантии всем размещённым на нём машинам. На рисунке показаны две машины с одним ядром каждая, у первой coreFraction: 20%, у второй coreFraction: 80%.
Автоматический coreFraction (Auto)
Долю процессорного времени Deckhouse Platform (DP) может подбирать сам, следя за тем, сколько машина потребляет.
Возможность доступна в коммерческих редакциях DP и находится в стадии Alpha. Она требует включённого модуля vertical-pod-autoscaler, который подбирает долю ядра, и функции HotplugCPUAndMemoryWithInPlaceResize в настройках модуля. Функция работает с Kubernetes версии 1.33 и выше на управляющем слое и на всех узлах, где запускаются ВМ.
Вместо фиксированного процента можно задать coreFraction: Auto. Тогда долю подбирает DP, повышая её, когда машине не хватает процессора, и понижая, когда машина простаивает. Число ядер и объём памяти при этом не меняются, а новая доля применяется без перезагрузки.
spec:
  cpu:
    cores: 4
    coreFraction: Auto
Подбор устроен так:
- Машина, созданная сразу со значением
Auto, начинает с 10% или ближайшего значения, разрешённого политикой сайзинга, потому что машина без истории потребления считается простаивающей. - Машина, переведённая на
Autoс фиксированного процента, сохраняет текущую долю и ждёт на ней первой рекомендации, поэтому переход не уменьшает гарантированную долю. Если текущая доля не входит в число шагов, применяется ближайший шаг выше неё, и только доля 100% заменяется ближайшим шагом ниже, потому что автоматически 100% не выбирается. - Доля меняется шагами. Если в политике сайзинга класса задан список
coreFractions, шагами становятся его значения, иначе используются 5%, 10%, 15%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90% и 99%. - Значение 100% автоматически не выбирается, потому что при нём запросы процессора сравниваются с лимитами, а такую машину нельзя изменить без перезагрузки. Если 100% указан в
coreFractions, он просто не используется, и потолком становится следующее значение вниз, а без политики сайзинга потолок равен 99%. - По той же причине политика сайзинга должна оставлять хотя бы два значения на выбор. Политика, разрешающая только 50% либо 50% и 100%, навсегда зафиксировала бы машину на 50%, поэтому такое сочетание отклоняется, и долю придётся задать явно.
- Рекомендованное значение публикуется в поле
.status.recommendedResources.cpu.coreFraction, а применённое — в.status.resources.cpu.coreFraction. О каждом изменении сообщает событиеCoreFractionScaling. - Если на узле не хватает места под новые запросы, машина переезжает на другой узел и продолжает работать.
Идёт ли подбор, показывает условие CoreFractionAutoscaling. Пока подбор работает, условие имеет статус True, а первые минуты, пока не накопится статистика, причиной будет WaitingForRecommendation, затем CoreFractionAutoscalingEnabled.
Если подбор стал недоступен, условие переходит в False, и причина объясняет, почему это произошло:
CoreFractionAutoscalingDisabled— выключено вертикальное автомасштабирование;InPlaceResizeDisabled— выключено изменение ресурсов на лету;SizingPolicyHasNoSteps— политику сайзинга сузили до одного значения.
Машина при этом продолжает работать с текущей долей, но перестаёт следовать за нагрузкой.
Чтобы отказаться от автоматического подбора, задайте явный процент. Переход между 100% и Auto в любую сторону требует перезагрузки машины, потому что меняет её класс QoS, а остальные переходы применяются на лету.
Политика сайзинга
Администратор может ограничить сочетания ресурсов, доступные машинам определённого класса, задав политику сайзинга в параметре .spec.sizingPolicies ресурса VirtualMachineClass. Если политики нет, ресурсы задаются произвольно.
Политика делит число ядер на диапазоны и для каждого задаёт допустимый объём памяти и разрешённые значения coreFraction:
spec:
  sizingPolicies:
    - cores:
        min: 1
        max: 4
      memory:
        min: 1Gi
        max: 8Gi
      coreFractions: [5, 10, 20, 50, 100]
    - cores:
        min: 5
        max: 8
      memory:
        min: 5Gi
        max: 16Gi
      coreFractions: [20, 50, 100]
С такой политикой машина с двумя ядрами попадает в первый диапазон, получает от 1 до 8 ГиБ памяти и одно из значений 5%, 10%, 20%, 50% или 100%. Машина с шестью ядрами попадает во второй диапазон, где памяти доступно от 5 до 16 ГиБ, а долей ядра — 20%, 50% или 100%.
Политика ограничивает и переподписку. Например, минимальное значение coreFraction: 20% гарантирует каждой машине пятую часть ядра, а значит переподписка не превысит 5 к 1.
Если конфигурация машины политике не отвечает, в статусе появляется условие SizingPolicyMatched со статусом False. Такая машина продолжает работать, но сохранить изменения её конфигурации не получится, пока ресурсы не приведут в соответствие политике. Это же происходит, когда администратор меняет политику у класса уже работающих машин.
Кроме границ диапазон может задавать шаг сетки в параметрах cores.step и memory.step, а также границы памяти в расчёте на одно ядро в блоке memory.perCore.
Запрос, нарушающий политику, отклоняется с сообщением, в котором указаны параметр и допустимые значения. Каждое сообщение заканчивается подсказкой check the sizing policy of the VirtualMachineClass or contact the administrator for more information, ниже она опущена.
Для класса supercpu с политикой выше сообщения выглядят так:
- число ядер вне всех диапазонов,
cores: 10—does not match any sizing policy of VirtualMachineClass "supercpu": its 10 CPU core(s) fall outside the allowed ranges (1-4, 5-8); set the number of cores (spec.cpu.cores) accordingly; - недопустимая доля ядра,
cores: 2иcoreFraction: 30%—the CPU core fraction "30%" is not allowed; set the core fraction (spec.cpu.coreFraction) to one of: 5%, 10%, 20%, 50%, 100%; - память вне диапазона,
cores: 2иsize: 16Gi—the memory size (16Gi) is out of the range allowed by the sizing policy; set the memory size (spec.memory.size) between 1Gi and 8Gi.
Если в диапазоне заданы шаг или границы памяти на ядро, добавляются ещё четыре сообщения:
- ядра не на сетке шага —
the number of CPU cores (7) does not match the sizing policy step; set the number of cores (spec.cpu.cores) to 6 or 8; - память не на сетке шага —
the memory size (1536Mi) does not match the sizing policy step; set the memory size (spec.memory.size) to 1Gi or 2Gi; - память на ядро вне диапазона —
the memory size (18Gi) is not allowed for 6 CPU core(s); set the memory size (spec.memory.size) between 6Gi and 12Gi, or change the number of cores (spec.cpu.cores) (the sizing policy allows between 1Gi and 2Gi of memory per core); - память на ядро не на сетке шага —
the memory size (2560Mi) does not match the per-core sizing policy step for 2 CPU core(s); set the memory size (spec.memory.size) to 2Gi or 4Gi, or change the number of cores (spec.cpu.cores).
Когда нарушений несколько, все причины перечисляются в одном сообщении под заголовком does not match the sizing policy of VirtualMachineClass "supercpu" for several reasons:.
Топологии CPU
Топология определяет, как ядра процессора машины распределяются по сокетам, и от неё зависит совместимость с приложениями, чувствительными к конфигурации процессора. Вы задаёте только общее число ядер в параметре .spec.cpu.cores, а число сокетов DP рассчитывает сам:
spec:
  cpu:
    cores: 20
Чем больше ядер, тем на большее число сокетов они делятся, и тем крупнее шаг, с которым можно менять их количество. Общее число ядер должно быть кратно числу сокетов, иначе запрос отклоняется.
| Число ядер | Сокетов | Кратность | Ядер в сокете |
|---|---|---|---|
1 ≤ cores ≤ 16 |
1 | 1 | от 1 до 16 |
16 < cores ≤ 32 |
2 | 2 | от 9 до 16 |
32 < cores ≤ 64 |
4 | 4 | от 9 до 16 |
64 < cores ≤ 248 |
8 | 8 | от 9 до 31 |
Например, 20 ядер дают два сокета по 10 ядер, а 80 ядер — восемь сокетов по 10. Максимум для одной машины составляет 248 ядер и 1024 ГБ оперативной памяти.
Рассчитанную топологию DP публикует в статусе:
status:
  resources:
    cpu:
      topology:
        coresPerSocket: 10
        sockets: 2
Накладные расходы памяти зависят от фактически активных ядер и составляют 8 МиБ на каждое логическое ядро, то есть на произведение числа сокетов, ядер в сокете и потоков на ядро.